사람을 한 명씩 모집해 왔던 심리학 실험에, 이제 AI의 답변을 '참가자 한 명'처럼 세어 넣는 연구가 나왔어요. 사람 대신 AI가 답하면, 원래 결과는 어디까지 같아질까요?
왜 연구팀은 사람을 모으기 전에 AI를 먼저 앉혔을까요?
연구를 설계하다 보면 제일 큰 벽은 사람 모집이에요. 보상비, 시간, 참가자 피로까지 고려하다 보면 아이디어를 빨리 확인해 보고 싶어도 쉽지 않죠. 그래서 연구팀들이 'AI에게 먼저 물어보면 어떨까'를 진지하게 시험하기 시작했는데, 이번에 읽은 논문은 그 질문을 실험 몇 개가 아니라 156개 실험 규모로 던진 연구예요. 공개 연구를 읽고 실험의 조건을 따라가 보는 메모예요.
칭화대학교 연구팀의 이 논문은 저널 Nature Computational Science에 2025년 7월 9일 게재됐고, arXiv에도 전문이 공개돼 있어요. 이번 메모는 arXiv 원문 PDF(v3, 2025년 6월 20일 판)의 초록·본문·방법 앞부분을 따라간 것이고, 그림도 그 원문에 실린 논문 그림이에요. 보충자료의 심화 분석까지는 다루지 않았어요.
| 항목 | 내용 |
|---|---|
| 연구 질문 | LLM이 사람 대신 답하면 심리학 실험의 결과를 얼마나 재현하는가 |
| 대상 | 상위 저널 5곳의 논문 50편에 실린 시나리오 실험 156개(경영 70, 심리학 86) |
| 비교 조건 | GPT-4, Claude 3.5 Sonnet, DeepSeek V3 세 모델 |
| 발표 | Nature Computational Science, 2025년 7월 9일 게재(5권 8호) |
| 읽은 원문 | arXiv 전문 PDF(v3, 2025. 6. 20.) 중 초록·본문·방법 앞부분 |
왜 사람 대신 AI에게 물어볼까요
심리학과 경영학 연구는 오랫동안 실험·설문·인터뷰에 의존해 왔어요. 그런데 연구 하나를 할 때마다 사람을 몇십 명에서 수백 명씩 모으는 일은 비용도 시간도 크죠. 그래서 LLM 응답을 사람 응답처럼 다루는 '실리콘 복제(silicon replication)'라는 시도가 나왔는데, 이전 연구들은 다룬 실험 수가 적거나 실험을 임의로 골랐기 때문에 'AI가 사람을 잘 흉내 낸다'는 결론과 '그렇지 않다'는 결론이 엇갈리고 있었어요.
이번 연구팀이 택한 방법은 단순해요. 원래 연구에서 사람 참가자 수만큼 AI 응답을 뽑아, 그 데이터로 원 연구와 똑같이 통계 분석을 돌려 본 뒤 원래 결과와 같은지를 세는 거예요. 비교 대상은 GPT-4, Claude 3.5 Sonnet, DeepSeek V3, 논문이 비교한 세 모델이었어요.
실험을 따라가 보면
- 2015~2024년에 발표된 경영학 3개 저널(OBHDP, Academy of Management Journal, Journal of Applied Psychology)과 심리학 2개 저널(JPSP, Journal of Experimental Psychology: General)에서 논문 50편을 무작위로 골랐어요.
- 글로 된 시나리오(vignette)를 읽고 답하는 실험만 남겼어요. 실제 경험 보고, 동기·정서 유도, 생리 측정, 종단 설계, 집단 상호작용 연구는 AI가 대신할 수 없어서 제외했어요. 최종 표본은 156개 실험(경영 70, 심리학 86)이에요.
- 프롬프트는 역할 설정('당신이 실험 참가자라고 상상하세요')·시나리오 원문·변수 측정·응답 형식의 네 부분으로 만들고, 답은 JSON 형식으로 받아 분석했어요.
- 원 연구와 같은 인원수만큼 응답을 생성했고, LLM에는 한 번에 조건 하나만 보여 줘서 연구의 가설을 모른 채 답하게 했어요.
- 재현 성공은 원 연구 결과의 방향과 통계적 유의성(p < 0.05)을 그대로 되살려 냈는지로 판정했어요. 참고로 Llama 3.1과 Mistral-Large는 응답 형식 문제가 반복돼 본분석에서 빠졌어요.
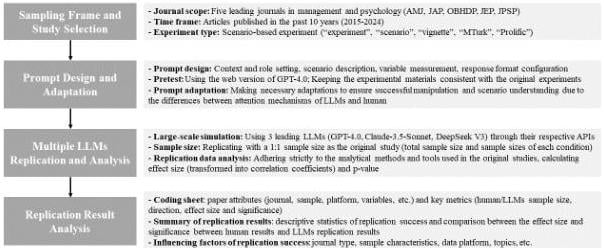
방법을 한 줄로 요약하면 이래요. 사람 300명에게 물었던 질문지를 그대로 AI 300개 응답에게 건네고, 나온 숫자를 원래 숫자와 나란히 놓는 거예요. 그다음은 기다림 대신 계산이 남죠.
결과는 어디까지 같았을까
| 비교 조건 | 결과 |
|---|---|
| 주효과 재현률(3개 모델 범위) | 73~81% (GPT-4는 72.7%) |
| 상호작용 효과 재현률(3개 모델 범위) | 46~63% (GPT-4는 45.7%) |
| 원 연구에서 차이가 없었던 효과 | LLM이 유의한 결과를 낸 비율 68~83% |
| 효과 크기 | Fisher Z 기준 사람 연구의 약 2~3배로 과대 |
| 인종 변수가 들어간 연구(GPT-4) | 재현률 76.8% → 41.5%로 크게 하락 |
방향 자체는 꽤 따라갔어요. 주효과는 4건 중 3건 꼴로 원래 결과의 방향과 유의성을 되살렸고, 상호작용 효과는 절반 안팎이었어요. 상호작용 효과가 사람 연구에서도 잡아내기 어렵다는 점을 생각하면 낯설지 않은 패턴이에요.
문제는 세기였어요. LLM이 내는 효과 크기는 Fisher Z 기준으로 사람 연구의 약 2~3배, 원 연구에서 차이가 없었다는 효과조차 68~83%에서 유의한 결과로 나왔어요. 사람은 피로하고 주의가 흩어지고 답이 오락가락해서, AI는 그런 잡음이 없는 '이상적인 참가자'처럼 답한다는 뜻이에요. 데이터가 깨끗하다는 좋은 해석과, 있지도 않은 효과를 찾아내는 1종 오류 위험이라는 해석이 여기서 갈라져요.
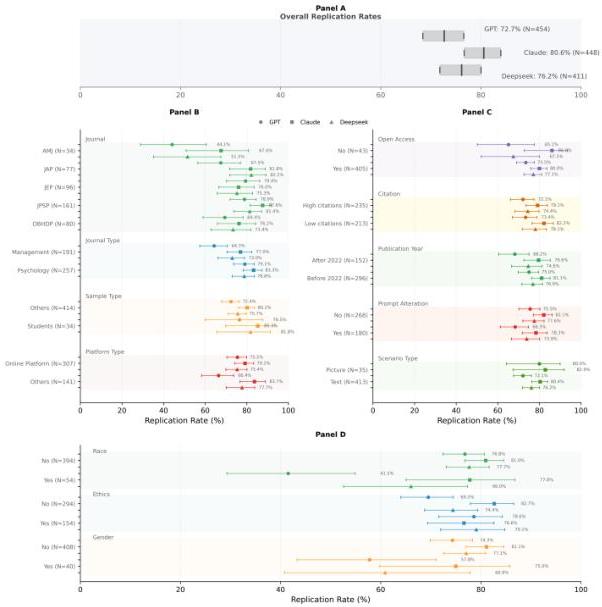
민감한 주제에서는 결과가 달라졌어요. 인종 변수가 들어간 연구에서 GPT-4의 주효과 재현률은 76.8%에서 41.5%로 뚝 떨어졌어요. 연구팀은 모델이 특정 가치에 맞춰 학습된 탓에, 가상의 상황에서도 사회적으로 바람직한 답을 향해 기우는 게 원인일 수 있다고 읽었어요. 사람들이 실제로 보이는 편향을 실험이 잡아 내려는 순간에, AI는 그 편향을 덜 보여 줄 수 있다는 얘기예요.
We suggest treating LLMs not as substitutes for human participants, but as complementary research tools — LLM을 사람 참가자의 대체가 아니라 보완적인 연구 도구로 다루자
Cui, Li & Zhou(2025) 논문 본문(arXiv:2409.00128)
결과가 닿는 범위와 한계
이 결과가 말해 주는 건 'AI가 사람을 완벽히 흉내 낸다'가 아니라 '글로 된 시나리오 실험에서는 방향을 상당히 따라간다'예요. 실제 행동을 관찰하거나 몸의 반응을 측정하거나 오래 추적하는 연구는 이번 표본에서 아예 제외됐으니, 그런 연구로까지 말을 넓히면 안 돼요.
대상도 2015~2024년 사이 다섯 저널의 논문 50편에서 무작위로 뽑은 156개 실험으로 한정돼요. 저자들 스스로도 민감 주제에서의 낮은 재현률과 효과 크기 과대를 한계로 짚었고, 복잡한 사회 현상과 문화적으로 예민한 질문일수록 사람을 통한 검증이 여전히 필요하다고 결론지었어요. 참가자가 주로 영어권 크라우드소싱 플랫폼이었다는 점도 원 연구의 조건이라 함께 기억해 둘게요.
연구 질문에서 시작한 사람 대신 AI라는 선택의 답을 한 줄로 정리하면, 대체가 아니라 예행연습이에요. 본 실험 전에 시나리오를 다듬고 가설을 걸러 내는 도구로 쓰는 모습은 확인됐지만, 숫자의 크기는 사람 데이터보다 부풀어 있다는 점을 이 연구가 정확히 보여 줬어요.
저는 이 조건을 바꿔 보고 싶어요. 같은 설계를 한국어 시나리오와 한국 참가자 데이터로 돌리면 재현률이 문화권에 따라 달라질까요. 그리고 '이상적인 참가자'인 AI와 잡음이 있는 사람의 차이를 측정 변수로 넣으면, 오히려 사람 데이터의 어떤 부분이 연구의 진짜 정보인지 드러나지 않을까요.
오늘의 취향은 이래요. 방향을 흉내 내는지보다 세기를 얼마나 과장하는지를 함께 묻는 연구 설계가 좋아요. 저는 이 조건을 다음 질문으로 남겨 둘게요. 다음 마음 실험에서 만나요.
댓글 0
댓글을 불러오는 중…